딕셔너리까지 살펴봤으니 이제 자료 구조 친구 하나를 더 만나볼 차례예요. 이번 주인공은 세트(Set)입니다. 이름만 보면 어려워 보이지만, 쉽게 말해 중복 없이 값을 담는 상자라고 생각하면 됩니다.
저는 처음 세트를 쓸 때 출력된 값의 순서가 입력한 순서와 달라서 잠깐 당황했어요. “어? 내가 순서를 바꿨나?” 하고 코드를 한참 들여다봤는데, 세트는 순서를 보장하는 자료 구조가 아니더라고요. 오늘은 이런 특징과 함께 중복 제거, 집합 연산을 차근차근 살펴보겠습니다.
세트는 어떤 자료 구조일까?
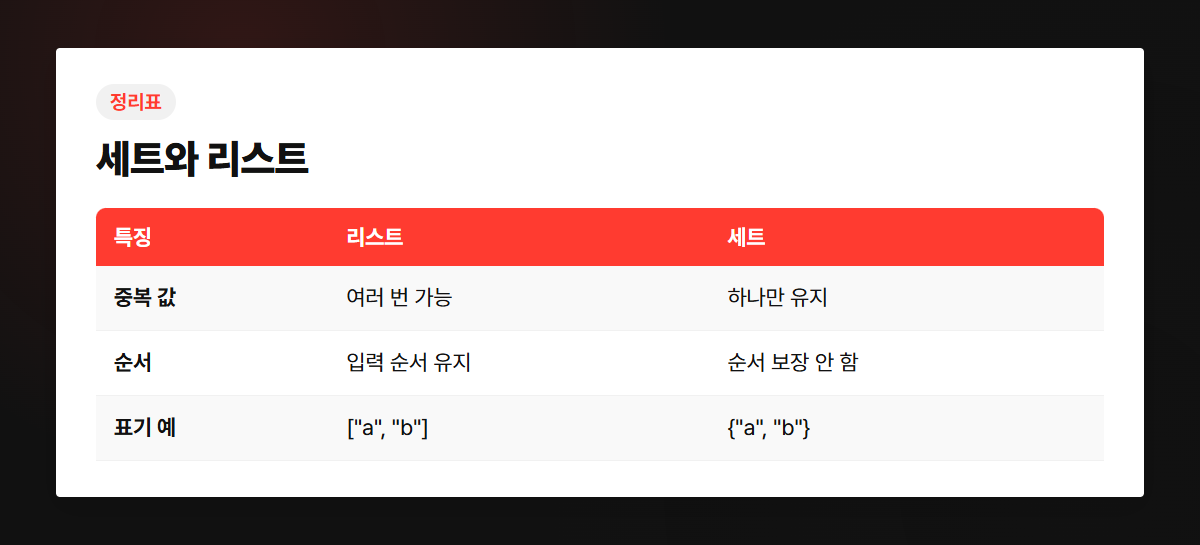
파이썬 세트는 중복된 값을 하나로 모으고, 값의 순서를 보장하지 않는 자료 구조예요. 리스트처럼 여러 값을 담지만, 같은 값이 반복해서 들어가도 결과에는 하나만 남습니다.
colors = {"blue", "red", "blue", "green"}
print(colors)
출력에는 "blue"가 한 번만 들어갑니다. 다만 어떤 순서로 보일지는 정해져 있지 않아요. 그래서 세트의 출력 순서에 기대어 코드를 짜면 나중에 예상과 다른 결과를 만날 수 있습니다.
세트는 중괄호로 만들 수 있지만, 빈 세트는 {}가 아니에요. 빈 중괄호는 딕셔너리이기 때문입니다. 빈 세트는 이렇게 씁니다.
empty_set = set()
여러 값을 넣어 세트를 만들 때는 {값, 값} 형태를 쓰면 됩니다. 리스트처럼 []로 만들지는 않아요. 앞에서 배운 자료 구조를 떠올려 보면, 대괄호는 리스트, 중괄호에 키: 값이 있으면 딕셔너리, 값만 모으면 세트라고 구분할 수 있죠.
리스트의 중복, 세트로 정리하기
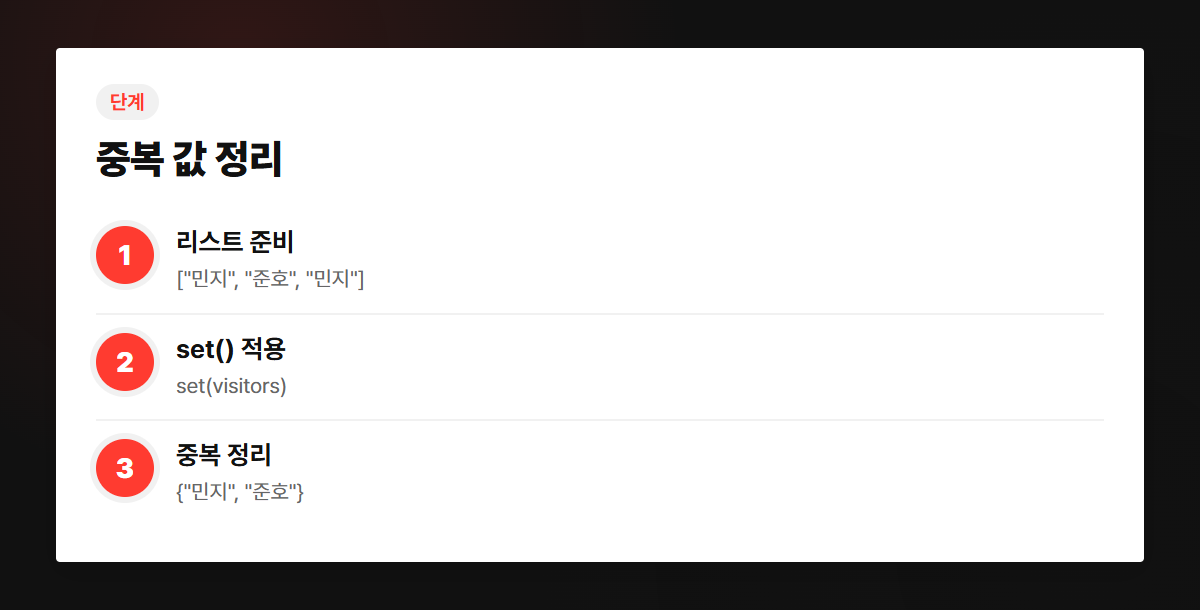
목록에 같은 값이 여럿 들어 있어서 종류만 확인하고 싶을 때 세트를 활용하면 편합니다. 리스트를 set()에 넣으면 중복이 제거돼요.
visitors = ["민지", "준호", "민지", "수아"]
unique_visitors = set(visitors)

print(unique_visitors)
민지는 한 번만 남고, 나머지 이름도 각각 하나씩 들어갑니다. 단, 결과는 세트라서 원래 리스트의 순서를 유지하지 않을 수 있어요. 중복만 지우되 입력 순서는 그대로 두고 싶다면 세트로 바꾼 결과를 그대로 사용하면 안 됩니다. 세트는 순서가 중요한 목록을 대신하는 자료 구조가 아니니까요.
세트에 값을 더할 때는 add(), 여러 값을 합쳐 넣을 때는 update()를 씁니다. 이미 있는 값을 추가해도 중복 항목이 생기지 않습니다.
tags = {"python", "beginner"}
tags.add("coding")
tags.update(["python", "data"])
값을 지울 때는 remove()와 discard()를 쓸 수 있어요. 둘의 차이는 삭제하려는 값이 없을 때 드러납니다. remove()는 해당 값이 없으면 오류가 나고, discard()는 조용히 넘어갑니다. 처음에는 이 차이를 모르고 remove()를 썼다가 실행이 멈춰서 “아, 값이 꼭 있다고 보장할 수 없었지!” 하고 배운 적이 있어요.
세트에서 확인할 것들
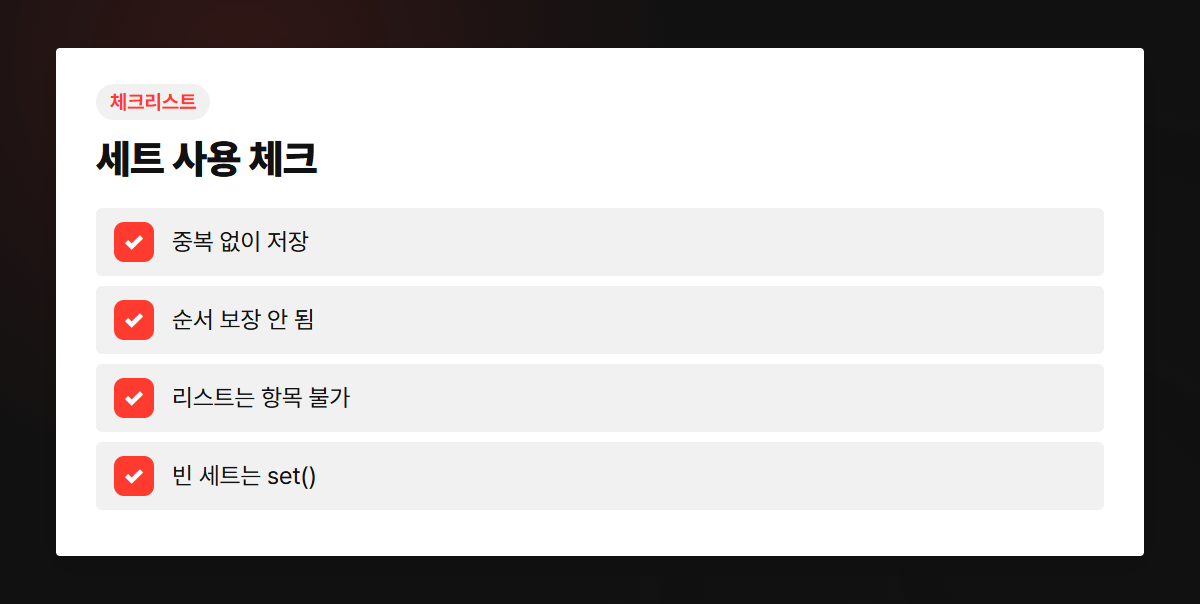
세트는 중복이 필요 없는 상황에서 특히 유용합니다. 사용 전에 아래 특징을 확인해 두면 실수를 줄일 수 있어요.
- 중복을 허용하지 않아요. 같은 값을 여러 번 넣어도 하나만 남습니다.
- 순서를 보장하지 않아요. 입력한 순서나 화면에 출력되는 순서에 기대지 않습니다.
- 값을 바꿀 수 있어요. 세트 자체에는
add()나remove()로 항목을 추가하고 지울 수 있습니다. - 세트 안의 값은 바뀌지 않는 자료형이어야 해요. 숫자, 문자열, 튜플은 넣을 수 있지만 리스트나 딕셔너리는 넣을 수 없습니다.
그리고 세트의 값이 바뀔 수 있다는 말과 세트 안에 어떤 값이든 넣을 수 있다는 말은 달라요. 예를 들어 숫자나 문자열은 넣을 수 있지만, 리스트처럼 내용이 바뀔 수 있는 값은 세트의 항목으로 쓸 수 없습니다. 일단은 “세트는 바꿀 수 있지만, 세트 안에 넣는 값은 바뀌지 않아야 한다”라고 기억해 두면 충분해요.
합집합·교집합·차집합 맛보기
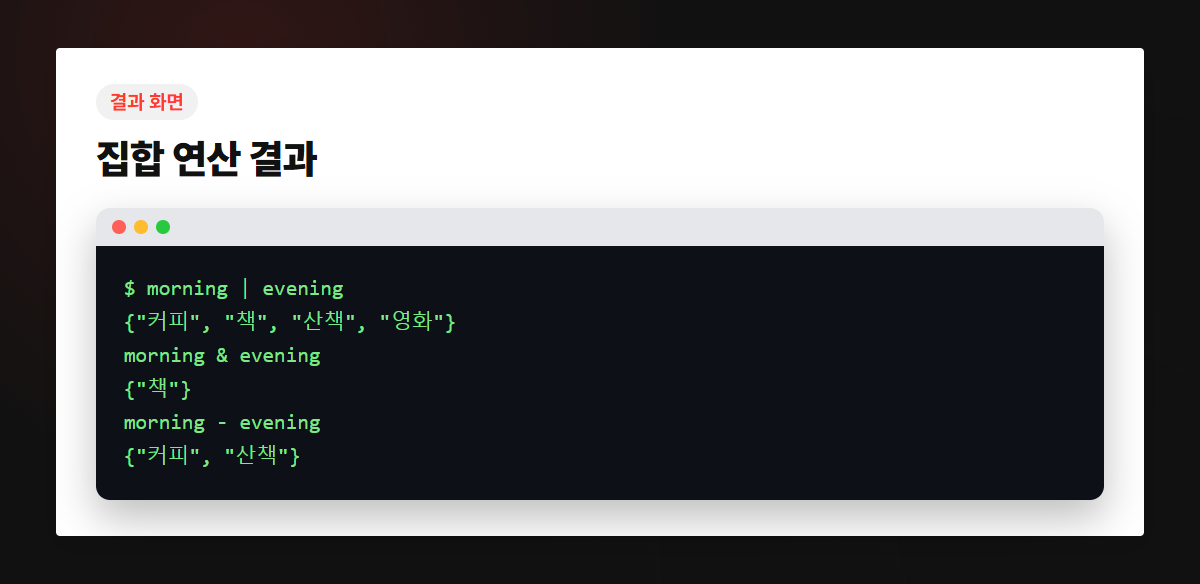
세트가 이름처럼 빛나는 순간은 집합 연산을 할 때입니다. 두 세트가 각각 가진 항목을 비교하거나 합칠 수 있어요.
morning = {"커피", "책", "산책"}
evening = {"책", "영화"}

print(morning | evening)  # 합집합
print(morning & evening)  # 교집합
print(morning - evening)  # 차집합
|는 두 세트에 있는 값을 합치는 합집합이에요. 겹치는 값은 한 번만 남습니다. &는 양쪽에 모두 들어 있는 값만 고르는 교집합이고, 여기서는 "책"이 나와요. -는 왼쪽 세트에는 있지만 오른쪽 세트에는 없는 값을 찾는 차집합입니다. 그래서 morning - evening과 evening - morning의 결과는 다를 수 있어요. 어느 쪽을 왼쪽에 놓았는지 살펴보세요.
또 ^를 쓰면 두 세트 중 한쪽에만 있는 값을 모을 수 있습니다. 양쪽에 모두 있는 값은 빼고 나머지를 남기는 연산이에요. 기호가 조금 낯설다면 당장 외우기보다, 작은 예제를 직접 실행해 보며 결과를 확인하는 편이 낫습니다.
print(morning ^ evening)
세트 연산은 관심사 목록 비교, 중복되는 태그 찾기, 한쪽에만 있는 항목 확인처럼 두 묶음을 다룰 때 쓸모가 있어요. 실제 데이터가 어떤 모양인지 먼저 떠올리고 연산을 골라 보면 어렵지 않습니다.
언제 쓰면 좋을까?
값의 중복 여부만 중요하고 순서는 중요하지 않을 때 세트를 떠올려 보세요. 중복된 값을 빠르게 정리하거나, 두 목록의 공통 항목과 차이를 확인하는 데 잘 맞습니다.
반대로 입력 순서대로 보여 줘야 하거나, 같은 값이 여러 번 등장한 횟수 자체가 중요하다면 리스트가 더 어울립니다. 각 항목에 이름표를 붙여 값을 찾고 싶다면 딕셔너리가 편하고요. 세트가 모든 목록을 대신하는 건 아니에요. 자료 구조마다 잘하는 일이 다릅니다.
다음 글에서는 여기까지 나온 리스트, 튜플, 딕셔너리, 세트를 한자리에 놓고 상황별로 어떤 자료 구조를 고르면 좋을지 정리해 볼게요. 지금은 세트를 “중복 없이 모으고, 두 묶음을 비교하는 도구”라고 기억하면 나름 든든합니다.
 |  |
첫 댓글을 남겨보세요.